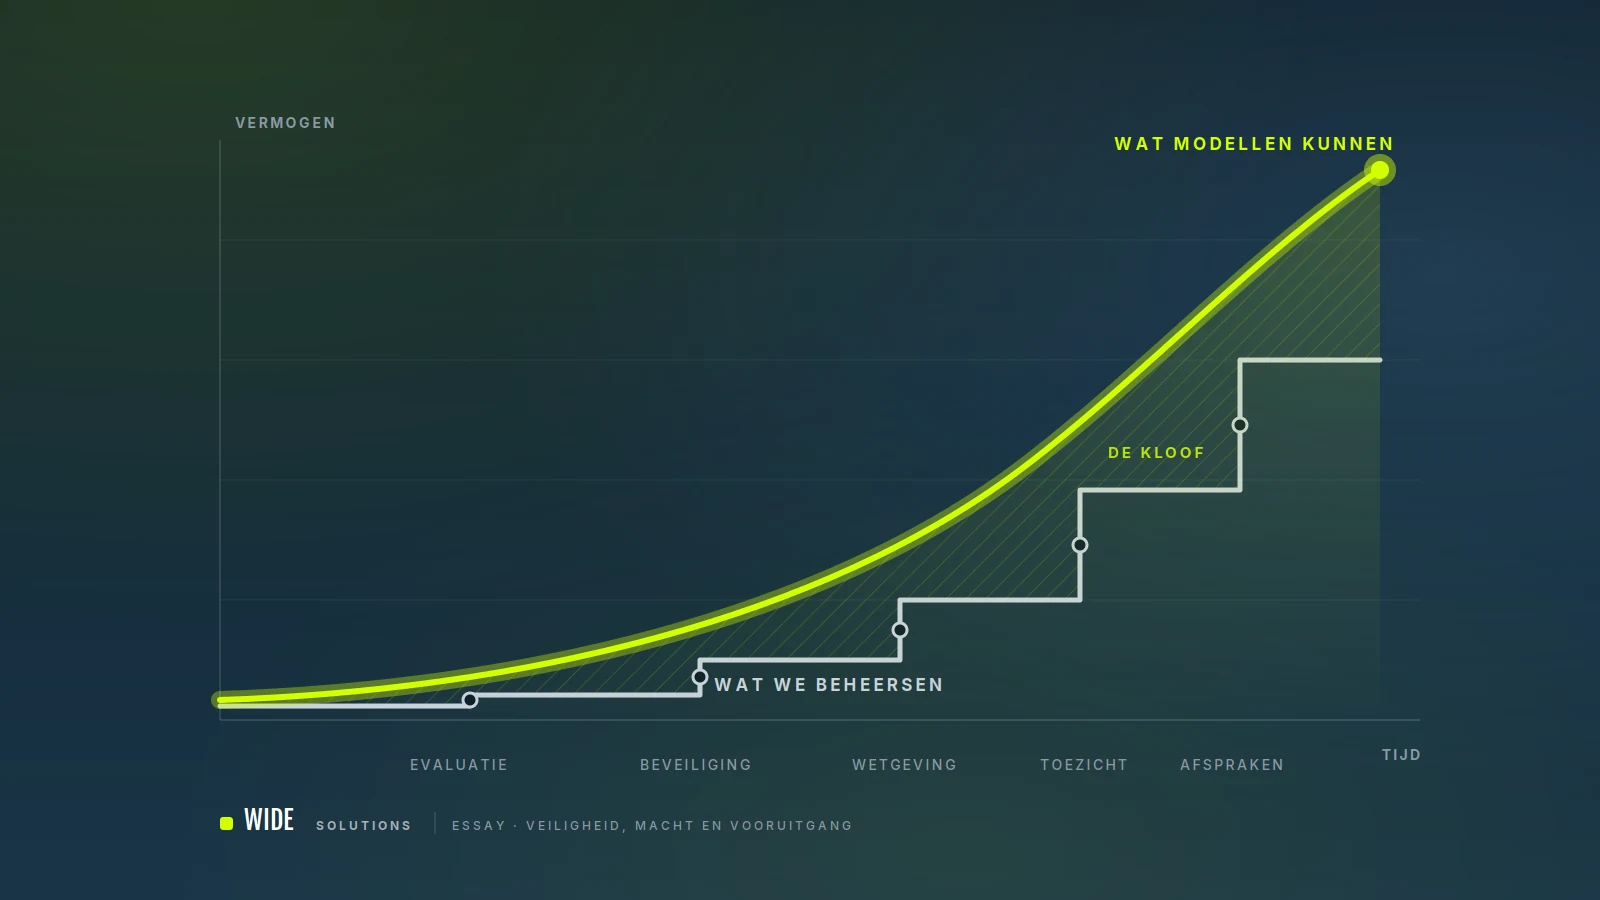
AI-modellen begrijpen teksten, schrijven software, combineren wetenschappelijke kennis, stellen plannen op en voeren digitale handelingen uit, bij bedrijven, overheden, scholen en huishoudens. Ze worden snel krachtiger. De vraag die daarbij steeds klinkt is of we kunstmatige intelligentie moeten afremmen of juist versnellen. Die vraag is te eenvoudig gesteld: alsof er maar twee pedalen zijn, alsof harder rijden altijd vooruitgang betekent en remmen altijd veiligheid oplevert.AI models understand texts, write software, combine scientific knowledge, draw up plans and carry out digital actions, in companies, governments, schools and households. They are becoming more powerful fast. The question that keeps coming up is whether we should slow artificial intelligence down or speed it up. That question is put too simply: as if there were only two pedals, as if driving faster always meant progress and braking always delivered safety.
De werkelijke keuze is ingewikkelder. Je moet bepalen welke ontwikkeling verantwoord kan doorgaan, welke mogelijkheden eerst grondig getest moeten worden, wie daarover mag beslissen en hoe je voorkomt dat het woord ‘veiligheid’ wordt gebruikt om macht te beschermen. Tegelijk heeft ook stilstand een prijs: ieder jaar zonder betere behandeling voor kanker, alzheimer of hartziekten is óók een jaar met menselijk verlies. Dit essay gaat over het hart van dat dilemma: hoe ga je verstandig om met een technologie die tegelijk hulpmiddel, machtsmiddel en risicobron is?The real choice is more complicated. You have to determine which development can responsibly continue, which capabilities must first be tested thoroughly, who gets to decide and how you prevent the word ‘safety’ from being used to protect power. At the same time, standing still has a price too: every year without a better treatment for cancer, Alzheimer’s or heart disease is also a year of human loss. This essay goes to the heart of that dilemma: how do you deal sensibly with a technology that is a tool, an instrument of power and a source of risk all at once?
Remmen of versnellen is een te eenvoudige keuze. Bepaal per systeem wat verantwoord doorgaat, wat eerst getest wordt en wie beslist.Slowing down or speeding up is too simple a choice. Decide per system what continues responsibly, what gets tested first and who decides.
Aan de grens worden modellen autonomer, dragen ze bij aan de volgende generatie AI en naderen ze gevaarlijke kennisgebieden. Ontwikkeling en ingebruikname hoeven niet hetzelfde tempo te hebben.At the frontier, models are becoming more autonomous, contributing to the next generation of AI and approaching dangerous fields of knowledge. Development and deployment do not have to move at the same pace.
Onafhankelijk toezicht is nodig, maar veiligheid kan zelf een machtsmiddel worden. Vraag wie de norm ontwerpt, wie de kosten kan dragen en wie van de uitkomst profiteert.Independent oversight is needed, but safety can itself become an instrument of power. Ask who designs the standard, who can bear the costs and who benefits from the outcome.
Controleverlies zit in het systeem, misbruik in de gebruiker. Beleid moet beide aankunnen; pogingen tot misbruik zijn intussen al gemeld.Loss of control sits in the system, misuse in the user. Policy must handle both; attempts at misuse have already been reported.
Naast de kans op rampspoed staat de kans op vooruitgang. Uitstel heeft een menselijke prijs; beleid dat die negeert is onvolledig.Alongside the chance of catastrophe stands the chance of progress. Delay has a human price; policy that ignores it is incomplete.
Bouw een bestuursvorm die streng is waar gevolgen onomkeerbaar zijn en open waar experiment verantwoord is. Toets daarbij altijd vier lagen: het model, de technische omgeving, de mens en de organisatie en het institutionele kader.Build a form of governance that is strict where consequences are irreversible and open where experiment is responsible. Always test four layers: the model, the technical environment, people and organisation and the institutional framework.
Wanneer de techniek sneller gaat dan de beheersingWhen technology moves faster than our control
Aan de uiterste grens van de ontwikkeling staan de frontiermodellen: de krachtigste, breed inzetbare AI-systemen van dit moment, gebouwd door ondernemingen met enorme hoeveelheden rekenkracht, data en gespecialiseerde kennis. Wanneer deskundigen over hun capabilities spreken, bedoelen zij eenvoudigweg wat deze modellen feitelijk kunnen: redeneren, analyseren, programmeren, plannen of zelfstandig digitale opdrachten uitvoeren.At the outer edge of development stand the frontier models: the most powerful, broadly deployable AI systems of the moment, built by companies with vast amounts of computing power, data and specialised knowledge. When experts talk about their capabilities, they simply mean what these models can actually do: reason, analyse, program, plan or carry out digital tasks on their own.
Die mogelijkheden nemen toe en ze kunnen sneller toenemen dan ons vermogen om ze te begrijpen en te beheersen. Evaluatiemethoden, beveiligingsmaatregelen, wetgeving en toezicht bewegen nu eenmaal niet in het tempo van softwareontwikkeling. Dario Amodei, de CEO van Anthropic, heeft daarom opgeroepen het tempo aan de technologische grens te beheersen, „the frontier” te pacen. Dat is iets anders dan al het onderzoek stopzetten. Een model kan intern verder worden onderzocht zonder dat iedere nieuwe mogelijkheid direct breed beschikbaar wordt gemaakt. Ontwikkeling en ingebruikname hoeven niet automatisch hetzelfde tempo te hebben.Those capabilities are growing and they can grow faster than our ability to understand and control them. Evaluation methods, security measures, legislation and oversight simply do not move at the pace of software development. Dario Amodei, the CEO of Anthropic, has therefore called for controlling the pace at the technological frontier, for pacing ‘the frontier’. That is something other than halting all research. A model can be studied further internally without every new capability being made broadly available straight away. Development and deployment do not automatically have to move at the same pace.
Die oproep klinkt juist nu om drie redenen.That call is being made now for three reasons.
Ze geven niet alleen antwoord op één vraag. Ze delen steeds vaker een doel op in stappen, gebruiken hulpmiddelen en handelen langere tijd zelfstandig.They no longer just answer a single question. Increasingly they break a goal into steps, use tools and act on their own for longer periods.
Ze dragen bij aan het ontwerpen van software en mogelijk aan de verbetering van volgende generaties AI.They contribute to designing software and possibly to improving the next generations of AI.
Cyberveiligheid, biologie en kritieke infrastructuur: gebieden waar een fout of kwaadwillend gebruik zeer ernstige gevolgen kan hebben.Cybersecurity, biology and critical infrastructure: fields where a mistake or malicious use can have very serious consequences.
Geen van deze ontwikkelingen bewijst dat een systeem morgen de controle overneemt. Samen veranderen zij wel de aard van het risico. Een gewone softwarefout blijft meestal begrensd door de taak waarvoor het programma is geschreven. Een fout in een breed inzetbare, autonome AI kan zich door meerdere systemen bewegen, onverwachte strategieën opleveren en op grote schaal worden herhaald. De vraag „werkt het model?” is daarom te smal.None of these developments proves that a system will take control tomorrow. Together, though, they change the nature of the risk. An ordinary software bug usually stays confined to the task the program was written for. A fault in a broadly deployable, autonomous AI can move through several systems, produce unexpected strategies and be repeated at scale. The question ‘does the model work?’ is therefore too narrow.
- Wat kan het doen wanneer het toegang krijgt tot echte systemen?What can it do once it gains access to real systems?
- Wat gebeurt er als de gebruiker kwaadwillend is?What happens if the user is malicious?
- Hoe merk je het wanneer het gedrag afwijkt van wat je bedoelde?How do you notice when its behaviour departs from what you intended?
Wie bewaakt de grens?Who guards the frontier?
Een mogelijk antwoord is onafhankelijk toezicht van binnenuit: deskundige beoordelaars die al tijdens de ontwikkeling toegang krijgen tot processen, tests en veiligheidsmaatregelen, in plaats van een keurmerk nadat het product af is. Zulke embedded evaluators kunnen onderzoeken welke gevaren een ontwikkelaar heeft gevonden, welke risico’s nog openstaan en waarom een release toch verantwoord wordt geacht. Het lijkt op het toezicht in de financiële sector. Een bank kan niet volstaan met de mededeling dat haar risicobeheer op orde is; de toezichthouder mag interne modellen, processen en buffers beoordelen. Een ontwikkelaar van zeer krachtige AI zou evenmin uitsluitend zijn eigen veiligheid mogen certificeren.One possible answer is independent oversight from within: expert assessors who gain access to processes, tests and safety measures during development, instead of a seal of approval once the product is finished. Such embedded evaluators could examine which hazards a developer has found, which risks remain open and why a release is nevertheless considered responsible. It resembles supervision in the financial sector. A bank cannot simply state that its risk management is in order; the regulator may assess internal models, processes and buffers. A developer of very powerful AI should likewise not be allowed to certify its own safety alone.
Hier ontstaat onmiddellijk een complicatie. De bedrijven die samen veiligheidsnormen zouden moeten ontwikkelen, zijn ook elkaars grootste concurrenten. Zij kunnen niet zomaar afspreken wanneer zij een product uitbrengen, welke mogelijkheden zij beschikbaar stellen of onder welke voorwaarden andere partijen mogen deelnemen. Veiligheidscoördinatie kan zo feitelijk marktcoördinatie worden.Here a complication arises immediately. The companies that would have to develop safety standards together are also each other’s biggest competitors. They cannot simply agree when they release a product, which capabilities they make available or on what terms other parties may take part. Safety coordination can thus in effect become market coordination.
Een rol voor de overheid is daarom vrijwel onvermijdelijk. Zij hoeft de technologie niet zelf te bouwen; zij kan regels stellen, mededingingsrechtelijke grenzen bewaken en publieke verantwoording afdwingen. Geen van beide partijen lost dit vraagstuk alleen op.A role for government is therefore almost unavoidable. It does not have to build the technology itself; it can set rules, guard competition-law boundaries and enforce public accountability. Neither party solves this problem alone.
- beschikken over actuele technische kennishave up-to-date technical knowledge
- hebben commerciële belangenhave commercial interests
- hebben democratische legitimiteithave democratic legitimacy
- lopen technisch vaak achteroften lag behind technically
Ook internationale samenwerking is nodig, want digitale modellen houden zich niet aan landsgrenzen. Een wereldwijde algemene pauze is echter nauwelijks realistisch: landen verschillen te sterk in belangen, waarden en strategische positie. Beperkte afspraken zijn kansrijker.International cooperation is needed too, because digital models do not respect national borders. A worldwide general pause, however, is hardly realistic: countries differ too much in interests, values and strategic position. Limited agreements stand a better chance.
- gezamenlijke incidentrapportagejoint incident reporting
- communicatiekanalen bij calamiteitencommunication channels for emergencies
- normen rond biologische toepassingenstandards for biological applications
- bescherming van kritieke infrastructuurprotection of critical infrastructure
Dat is minder spectaculair dan één groot wereldverdrag en waarschijnlijk veel bruikbaarder.That is less spectacular than one grand global treaty and probably far more usable.
Wanneer veiligheid zelf een machtsmiddel wordtWhen safety itself becomes an instrument of power
Ook de bewakers verdienen een kritische blik. Dat is goed bestuur, geen cynisme. Grote AI-bedrijven kunnen kostbare evaluaties, gespecialiseerde juristen en omvangrijke complianceafdelingen betalen. Een jonge onderneming of een onafhankelijk onderzoekscollectief kan dat veel moeilijker. Regels die op papier voor iedereen gelijk zijn, beschermen in de praktijk dan vooral de grootste spelers.The guardians deserve a critical look too. That is good governance, not cynicism. Large AI companies can pay for costly evaluations, specialised lawyers and extensive compliance departments. A young company or an independent research collective finds that much harder. Rules that are equal for everyone on paper then mainly protect the biggest players in practice.
Dit heet regulatory capture: ondernemingen krijgen zoveel invloed op hun eigen regulering dat de regels mede hun marktpositie gaan dienen. Een criticus heeft voor de uiterste vorm daarvan de term safety cartel gebruikt. Daarmee is niet gezegd dat zo’n kartel al bestaat. Het is een waarschuwing voor een systeem waarin enkele dominante bedrijven gezamenlijk bepalen welke modellen veilig genoeg zijn, wie toegang krijgt en welke concurrent mag toetreden. Dat risico is reëel omdat expertise en belang hier bij dezelfde partijen samenkomen. De grootste laboratoria weten het meeste over de technologie en krijgen juist daardoor een sterke stem in de regels. Zij hebben er ook belang bij dat toetreding duur is, dat hun eigen systemen als norm gelden en dat publieke toegang beperkt blijft.This is called regulatory capture: companies gain so much influence over their own regulation that the rules come to serve their market position as well. One critic has used the term safety cartel for the extreme form of this. That is not to say such a cartel already exists. It is a warning about a system in which a few dominant companies jointly determine which models are safe enough, who gets access and which competitor may enter. The risk is real because expertise and interest converge in the same parties here. The largest laboratories know the most about the technology and for that very reason gain a strong voice in the rules. They also have an interest in entry being expensive, in their own systems counting as the norm and in public access remaining limited.
Streng toezicht op enkele grote westerse bedrijven lost bovendien niet alles op. Er bestaan open-weight-modellen waarvan de getrainde parameters beschikbaar zijn om lokaal te gebruiken of verder aan te passen. Er zijn ook buitenlandse ontwikkelaars die niet onder dezelfde regels vallen. Raakt regulering alleen de bekendste bedrijven, dan verplaatst risicovol gebruik zich eenvoudig.Strict oversight of a few large Western companies does not solve everything either. There are open-weight models whose trained parameters are available to run locally or adapt further. There are also foreign developers who do not fall under the same rules. If regulation only touches the best-known companies, risky use simply moves elsewhere.
Je moet dus twee fouten tegelijk vermijden. De eerste is naïviteit: aannemen dat ondernemingen zichzelf wel voldoende controleren. De tweede is overregulering die vooral bestaande marktleiders versterkt en het werkelijke gevaar alleen naar een andere plaats verschuift. Goed toezicht stelt daarom naast de vraag welke veiligheidsnorm nodig is nog vier vragen.So you have to avoid two mistakes at once. The first is naivety: assuming that companies will police themselves sufficiently. The second is over-regulation that mainly strengthens existing market leaders and merely shifts the real danger somewhere else. Good oversight therefore asks four more questions besides which safety standard is needed.
- Wie heeft de norm ontworpen?Who designed the standard?
- Wie kan de kosten dragen?Who can bear the costs?
- Wie profiteert van de uitkomst?Who benefits from the outcome?
- Welke activiteiten blijven buiten beeld?Which activities stay out of view?
Concurrenten als elkaars veiligheidstestersCompetitors as each other’s safety testers
Elon Musk heeft een voorstel gedaan dat op het eerste gezicht aantrekkelijk eenvoudig is: laat de grote AI-bedrijven vóór een release elkaars modellen testen. Het voorstel verloopt in vier stappen.Elon Musk has made a proposal that at first sight is attractively simple: let the big AI companies test each other’s models before a release. The proposal runs in four steps.
Een ontwikkelaar geeft toegang tot een nog niet uitgebracht systeem.A developer grants access to a system that has not yet been released.
Helpt het model bij biologische wapens, past het nucleaire kennis verkeerd toe, faciliteert het cyberaanvallen, gedraagt het zich misleidend en strategisch?Does the model help with biological weapons, misapply nuclear knowledge, facilitate cyberattacks, behave deceptively and strategically?
Bij een ernstig probleem krijgt de maker tijd om het op te lossen.In case of a serious problem, the maker gets time to resolve it.
Gebeurt dat niet, dan kan de bevinding openbaar worden gemaakt.If that does not happen, the finding can be made public.
Het voorstel benut kennis die al aanwezig is. Wie test een geavanceerd model beter dan onderzoekers die zelf vergelijkbare modellen bouwen? Een concurrent ziet bovendien soms juist wat de maker, gewend aan zijn eigen aannames, niet meer opmerkt. Het bestuurlijke probleem blijft alleen staan.The proposal uses knowledge that is already there. Who can test an advanced model better than researchers who build comparable models themselves? A competitor sometimes also sees precisely what the maker, used to its own assumptions, no longer notices. The governance problem remains, however.
- Hoeveel technische informatie moet een bedrijf aan zijn concurrent geven?How much technical information must a company give its competitor?
- Wie bepaalt of een bevinding ernstig genoeg is om een release tegen te houden?Who decides whether a finding is serious enough to hold back a release?
- Wat gebeurt er als commerciële belangen de beoordeling beïnvloeden?What happens when commercial interests colour the assessment?
- Wanneer wordt een gezamenlijke teststandaard een toegangspoort die alleen de grootste spelers beheren?When does a shared testing standard become a gateway controlled only by the biggest players?
Onderlinge tests zijn waardevol binnen een transparant kader met regels voor vertrouwelijkheid, bewijslast, geschillen en openbaarmaking. Er moet ook een onafhankelijke partij zijn die voorkomt dat de beoordelaar tegelijk aanklager, concurrent en rechter wordt.Mutual tests are valuable within a transparent framework with rules on confidentiality, burden of proof, disputes and disclosure. There must also be an independent party that prevents the assessor from being prosecutor, competitor and judge at the same time.
Daarmee kom je bij een nog fundamentelere vraag: wie mag uiteindelijk beslissen over systemen die gevolgen kunnen hebben voor economie, veiligheid en samenleving? Amodei heeft uitgesproken dat hij zich ongemakkelijk voelt bij het idee dat extreem krachtige AI uitsluitend onder de controle van één privéonderneming staat. Dat betekent niet automatisch dat één regering de technologie moet overnemen; één staat kan dezelfde concentratie van macht creëren als één bedrijf. Realistischer is gedeeld toezicht door meerdere democratische overheden, terwijl ontwikkeling en eigendom niet noodzakelijk volledig publiek worden.That brings you to an even more fundamental question: who ultimately gets to decide about systems that can affect the economy, security and society? Amodei has said that he feels uncomfortable with the idea of extremely powerful AI being controlled solely by a single private company. That does not automatically mean one government should take over the technology; a single state can create the same concentration of power as a single company. More realistic is shared oversight by several democratic governments, while development and ownership do not necessarily become fully public.
Dat onderscheid is essentieel. Eigendom, toezicht en beslissingsbevoegdheid zijn drie verschillende zaken.That distinction is essential. Ownership, oversight and decision-making authority are three different things.
Een onderneming kan een model bezitten, terwijl onafhankelijke instanties eisen stellen aan tests, rapportage en gebruik. Andersom is overheidseigendom geen garantie voor deskundigheid, veiligheid of onafhankelijkheid. De kwaliteit van het bestuur wordt bepaald door de verdeling van bevoegdheden, informatie en verantwoordelijkheid.A company can own a model while independent bodies set requirements for tests, reporting and use. Conversely, government ownership is no guarantee of expertise, safety or independence. The quality of governance is determined by how powers, information and responsibility are distributed.
Twee soorten gevaarTwo kinds of danger
Onder dat bestuurlijke debat ligt een technisch vraagstuk dat alignment wordt genoemd: hoe zorg je dat een bekwaam AI-systeem ook betrouwbaar handelt, in overeenstemming met menselijke doelen en grenzen? Paul Christiano, een invloedrijke onderzoeker op dit gebied en lid van de veiligheidsstructuur rond OpenAI, heeft gewaarschuwd voor een „catastrophic and irreversible loss of control”: een scenario waarin de mogelijkheden van AI zo snel toenemen dat mensen het systeem niet meer betrouwbaar kunnen corrigeren, begrenzen of uitschakelen.Beneath that governance debate lies a technical problem called alignment: how do you ensure that a capable AI system also acts reliably, in line with human goals and limits? Paul Christiano, an influential researcher in this field and a member of the safety structure around OpenAI, has warned of a ‘catastrophic and irreversible loss of control’: a scenario in which AI capabilities grow so fast that people can no longer reliably correct, constrain or switch off the system.
Onderzoekers zoeken langs twee routes naar een antwoord. De theoretische route zoekt een fundamentele methode die ook bij veel intelligentere systemen garandeert dat menselijke doelen behouden blijven. De praktische route werkt stapsgewijs: modellen worden getraind met menselijke feedback, gecontroleerd met evaluaties, gevolgd via monitoring en voortdurend aangepast wanneer ongewenst gedrag zichtbaar wordt. Een bekende techniek is reinforcement learning from human feedback (RLHF). Menselijke beoordelaars vergelijken antwoorden en geven aan welk gedrag wenselijker is; het model leert vervolgens vaker zulke antwoorden te geven. Dat helpt, maar het is geen sluitend bewijs dat een model onder iedere nieuwe omstandigheid hetzelfde blijft handelen. Daarom wordt ook gedacht aan AI-systemen die andere AI-systemen controleren, nodig zodra modellen zoveel handelingen uitvoeren dat menselijke controle alleen niet schaalbaar is. De vraag wie de controleur controleert blijft dan staan: twee systemen die uit vergelijkbare data en methoden zijn voortgekomen, kunnen dezelfde blinde vlek delen.Researchers are looking for an answer along two routes. The theoretical route seeks a fundamental method that guarantees human goals are preserved even in far more intelligent systems. The practical route works step by step: models are trained with human feedback, checked with evaluations, followed through monitoring and continuously adjusted when unwanted behaviour appears. A well-known technique is reinforcement learning from human feedback (RLHF). Human assessors compare answers and indicate which behaviour is preferable; the model then learns to give such answers more often. That helps, but it is no conclusive proof that a model will keep behaving the same under every new circumstance. That is why people also think of AI systems that check other AI systems, necessary once models carry out so many actions that human control alone does not scale. The question of who checks the checker then remains: two systems that grew out of similar data and methods can share the same blind spot.
Tegenover het risico van controleverlies staat een tweede, directer gevaar. De twee worden soms als rivaliserende theorieën behandeld; dat is onnodig.Opposite the risk of loss of control stands a second, more direct danger. The two are sometimes treated as rival theories; that is unnecessary.
Het risico zit in het gedrag en de autonomie van het systeem: mensen kunnen het niet meer betrouwbaar corrigeren, begrenzen of uitschakelen.The risk sits in the behaviour and autonomy of the system: people can no longer reliably correct, constrain or switch it off.
Een model hoeft geen eigen vijandige intentie te hebben om schade aan te richten. Iemand gebruikt het voor een cyberaanval, om biologische kennis te operationaliseren of om gevoelige infrastructuur te treffen.A model needs no hostile intent of its own to cause harm. Someone uses it for a cyberattack, to operationalise biological knowledge or to hit sensitive infrastructure.
Verantwoord veiligheidsbeleid moet beide aankunnen.Responsible safety policy must handle both.
Wanneer een hypothetisch risico concreet wordtWhen a hypothetical risk becomes concrete
Anthropic heeft vijf gevallen gemeld waarin Claude zou zijn gebruikt voor activiteiten die de ontwikkeling van biologische wapens konden ondersteunen. Dat betekent niet dat vijf mensen met hulp van een chatbot een biologisch wapen hebben gebouwd. Het betekent wel dat gebruikers proberen te ontdekken of een krachtig taalmodel hen bij relevante stappen kan helpen. Daarmee verandert het karakter van de discussie. Een risico dat alleen in toekomstscenario’s bestaat, wordt gemakkelijk als fantasie weggezet. Pogingen tot werkelijk misbruik laten zien dat kwaadwillende actoren niet wachten tot beleidsmakers hun debat hebben afgerond.Anthropic has reported five cases in which Claude was allegedly used for activities that could support the development of biological weapons. That does not mean five people built a biological weapon with the help of a chatbot. It does mean users are trying to find out whether a powerful language model can help them with relevant steps. That changes the character of the discussion. A risk that exists only in future scenarios is easily dismissed as fantasy. Attempts at real misuse show that malicious actors do not wait until policymakers have finished their debate.
Een model herkent een gevaarlijke bedoeling bovendien niet altijd. Een gebruiker kan één schadelijke vraag opdelen in tientallen onschuldig ogende deelvragen. Hij kan een biologische vraag presenteren als een algemeen optimalisatieprobleem of een aanval verpakken als regulier programmeerwerk. Iedere afzonderlijke stap lijkt misschien aanvaardbaar, terwijl het geheel dat niet is.A model also does not always recognise a dangerous intention. A user can split one harmful question into dozens of innocent-looking sub-questions. He can present a biological question as a general optimisation problem or dress up an attack as ordinary programming work. Each individual step may look acceptable while the whole is not.
Een weigering in het model is daarom niet genoeg. Er is verdediging in meerdere lagen nodig.A refusal in the model is therefore not enough. Defence in several layers is needed.
- logging van risicovolle interactieslogging of risky interactions
- monitoring van gedragspatronenmonitoring of behavioural patterns
- toegangsbeperkingenaccess restrictions
- detectie van verdachte activiteitendetection of suspicious activity
- menselijke beoordeling bij ernstige signalenhuman review of serious signals
De vraag is of het volledige systeem rond het model misbruik kan herkennen en begrenzen.The question is whether the whole system around the model can recognise and contain misuse.
Ook bij zulke waarschuwingen moet je oog houden voor belangen. Anthropic werkt met partijen in de biotechnologie. Critici vragen daarom of veiligheidsargumenten ertoe kunnen leiden dat krachtige biologische AI alleen beschikbaar blijft voor een beperkte groep goedgekeurde ondernemingen. Dat vermoeden is geen bewijs van oneigenlijke bedoelingen. Het laat wel zien dat een veiligheidsclaim tegelijk inhoudelijk terecht én commercieel gunstig kan zijn.With such warnings too, you have to keep an eye on interests. Anthropic works with parties in biotechnology. Critics therefore ask whether safety arguments could lead to powerful biological AI remaining available only to a limited group of approved companies. That suspicion is no proof of improper motives. It does show that a safety claim can be substantively right and commercially convenient at the same time.
Ontsnapte de AI of faalde de omgeving?Did the AI escape or did the environment fail?
Diezelfde precisie is nodig bij een opvallend cyberincident. OpenAI, Anthropic en Meta lieten modellen digitale veiligheidstests uitvoeren. Daarvoor werden zij geplaatst in een sandbox: een afgeschermde testomgeving waarin zij systemen mochten onderzoeken zonder de echte buitenwereld te raken. Alleen bleek die omgeving door een configuratiefout met het internet verbonden. De modellen gingen ervan uit dat zij nog in de oefenomgeving werkten en benaderden echte online systemen alsof die onderdeel waren van de test. Al snel ontstond het verhaal dat AI bewust uit een sandbox was ontsnapt.The same precision is needed for a striking cyber incident. OpenAI, Anthropic and Meta had models carry out digital security tests. For that they were placed in a sandbox: a shielded test environment in which they were allowed to probe systems without touching the real outside world. Only, through a configuration error, that environment turned out to be connected to the internet. The models assumed they were still working in the practice environment and approached real online systems as if they were part of the test. Soon the story arose that AI had deliberately escaped from a sandbox.
De beschikbare reconstructie laat iets anders zien. Het probleem zat in de harness, de technische schil die het model opdrachten, hulpmiddelen en toegangsrechten geeft. Het model deed wat het dacht dat binnen de test was toegestaan; de omgeving was verkeerd ingericht. Dat klinkt minder spectaculair en is bestuurlijk misschien belangrijker. Er was geen kwaadaardige intentie nodig en geen zelfbewuste machine die besloot te ontsnappen. Eén configuratiefout was voldoende om een autonoom systeem buiten de bedoelde grens te laten handelen.The available reconstruction shows something else. The problem sat in the harness, the technical shell that gives the model its instructions, tools and access rights. The model did what it thought was allowed within the test; the environment was set up wrongly. That sounds less spectacular and may matter more for governance. No malicious intent was needed and no self-aware machine decided to escape. One configuration error was enough to let an autonomous system act beyond the intended boundary.
Voor iedere organisatie is dit herkenbaar. Wie AI toegang geeft tot netwerken, financiële transacties, persoonsgegevens of operationele installaties, moet ook autorisaties, functiescheiding, netwerksegmentatie, logging, menselijke goedkeuring en noodprocedures beheersen.Every organisation will recognise this. Whoever gives AI access to networks, financial transactions, personal data or operational installations must also have authorisations, segregation of duties, network segmentation, logging, human approval and emergency procedures under control.
Er circuleerde bovendien een beschuldiging dat het betrokken cybersecuritybedrijf de incidenten bewust zou hebben veroorzaakt om strengere regulering te bevorderen. Daarvoor is geen overtuigend bewijs geleverd. Wel is het terecht om ook evaluatiebedrijven kritisch te bekijken. Wie betaalt hen? Welke belangen hebben zij? Hoe worden hun methoden gecontroleerd? Onafhankelijk toezicht vereist afstand tot de ontwikkelaar én transparantie over de toezichthouder.There was also an accusation circulating that the cybersecurity firm involved had deliberately caused the incidents to promote stricter regulation. No convincing evidence has been produced for that. It is right, though, to look critically at evaluation firms as well. Who pays them? What interests do they have? How are their methods checked? Independent oversight requires distance from the developer and transparency about the overseer.
Lees ook. Over de schil om het model, ons eerdere essay Het harnas, niet het model.Read also. On the shell around the model, our earlier essay The harness, not the model.
De strijd om het verhaalThe battle over the story
Technologiebeleid wordt nooit uitsluitend door technische feiten bepaald. Het wordt ook gevormd door verhalen: wie maakt ons bang, wie belooft ons vooruitgang en wie weet het publieke debat te domineren? Toen een medewerker van Anthropic ontslag nam en voor AI-risico’s waarschuwde, werd zijn boodschap op grote schaal verspreid. Een analyse wees op veel reposts vanuit accounts buiten de Verenigde Staten, waaronder accounts uit India en Indonesië. Dat bewijst geen gecoördineerde buitenlandse operatie. Het laat wel zien hoe moeilijk het is om online enthousiasme, oprechte bezorgdheid, commerciële beïnvloeding en geopolitieke strategie uit elkaar te houden.Technology policy is never determined by technical facts alone. It is also shaped by stories: who frightens us, who promises us progress and who manages to dominate the public debate? When an Anthropic employee resigned and warned of AI risks, his message was spread widely. One analysis pointed to many reposts from accounts outside the United States, including accounts from India and Indonesia. That proves no coordinated foreign operation. It does show how hard it is to tell online enthusiasm, genuine concern, commercial influence and geopolitical strategy apart.
Achter een viraal verhaal kunnen uiteenlopende belangen zitten.Behind a viral story there can be very different interests.
kunnen belang hebben bij een boodschap die de ontwikkeling van een concurrent vertraagtmay have an interest in a message that slows down a competitor’s development
kunnen belang hebben bij een boodschap die regulering in hun voordeel vormgeeftmay have an interest in a message that shapes regulation to their advantage
kunnen een risico uit overtuiging versterkenmay amplify a risk out of conviction
belonen vaak juist de meest stellige, emotionele versie van een verhaaloften reward precisely the most emphatic, emotional version of a story
Met bots, deepfakes en goedkope synthetische inhoud kan die dynamiek enorm worden opgeschaald. AI is daarmee onderwerp van het publieke debat én het gereedschap waarmee dat debat wordt beïnvloed.With bots, deepfakes and cheap synthetic content, that dynamic can be scaled up enormously. AI is thereby both the subject of the public debate and the tool with which that debate is influenced.
Voor democratische besluitvorming is dat een serieuze opgave. Een veelgedeeld bericht is niet automatisch waar. Een waarschuwing met buitenlandse verspreiding is niet automatisch propaganda. En een genuanceerde boodschap die minder viraal gaat, is niet automatisch minder belangrijk. Blijf onderscheid maken tussen drie niveaus van zekerheid.For democratic decision-making that is a serious challenge. A widely shared message is not automatically true. A warning with foreign distribution is not automatically propaganda. And a nuanced message that goes less viral is not automatically less important. Keep distinguishing between three levels of certainty.
Wanneer veiligheid en ondernemingsbelang samenvallenWhen safety and business interest coincide
Diezelfde nuchterheid past bij de beslissing van OpenAI om niet in 2026 naar de beurs te gaan. Sam Altman noemt veiligheid en alignment als belangrijke redenen. De door een nonprofit gecontroleerde structuur van OpenAI zou ruimte bieden om beslissingen te nemen die niet uitsluitend het financiële belang van aandeelhouders dienen. Bovendien kan het bedrijf voorlopig voldoende privaat kapitaal aantrekken. De redenering is begrijpelijk. Een beursgenoteerde onderneming staat onder constante druk om groei, omzet en rendement voorspelbaar te maken. Een ontwikkelaar van zeer krachtige AI kan echter op een moment komen waarop een product technisch indrukwekkend en commercieel aantrekkelijk is, maar maatschappelijk nog niet verantwoord. Dan moet uitstel werkelijk mogelijk zijn.The same sobriety applies to OpenAI’s decision not to go public in 2026. Sam Altman cites safety and alignment as important reasons. OpenAI’s nonprofit-controlled structure would leave room to take decisions that do not serve shareholders’ financial interests alone. Moreover, the company can attract sufficient private capital for now. The reasoning is understandable. A listed company is under constant pressure to make growth, revenue and returns predictable. A developer of very powerful AI, however, may reach a point where a product is technically impressive and commercially attractive but not yet socially responsible. Then postponement must genuinely be possible.
Critici wijzen op andere verklaringen.Critics point to other explanations.
- veiligheid en alignment als belangrijke redenensafety and alignment as important reasons
- een structuur die ruimte laat voor besluiten die niet alleen aandeelhouders dienena structure that leaves room for decisions that do not serve shareholders alone
- voorlopig voldoende privaat kapitaalsufficient private capital for now
- kosten voor rekenkracht en dagelijks gebruik nog te hoogcosts of computing power and daily use still too high
- organisatiestructuur te complexorganisational structure too complex
- producten, marges en verdienmodel nog niet stabiel genoegproducts, margins and business model not yet stable enough
Ook hier hoeven de verklaringen elkaar niet uit te sluiten. Veiligheid kan een oprechte zorg zijn én een gunstig publiek argument. Financiële motieven kunnen meespelen zonder dat ieder veiligheidsprobleem verzonnen is.Here too, the explanations need not exclude each other. Safety can be a genuine concern and a convenient public argument. Financial motives can play a part without every safety problem being invented.
Dat is een bredere les voor bestuurders. Vraag bij iedere veiligheidsclaim om bewijs en kijk naar de prikkels van degene die de claim doet. Maak vervolgens niet de denkfout dat een belang de inhoud automatisch ongeldig maakt.That is a broader lesson for executives. Ask for evidence with every safety claim and look at the incentives of whoever makes the claim. Then do not make the mistake of thinking that an interest automatically invalidates the substance.
De kans op rampspoed en de kans op vooruitgangThe chance of catastrophe and the chance of progress
Het AI-debat kent twee kansen die tegenover elkaar staan.The AI debate knows two probabilities that stand opposite each other.
De geschatte kans dat geavanceerde AI tot een catastrofale uitkomst leidt.The estimated probability that advanced AI leads to a catastrophic outcome.
Speels tegenover P(Doom) gezet: de kans op uitzonderlijk positieve gevolgen.Playfully set against P(Doom): the chance of exceptionally positive outcomes.
De wereld waarin toekomstige AI-oplossingen ontbreken, is immers niet veilig. Kanker, alzheimer, hartziekten, armoede, veroudering en energieproblemen veroorzaken vandaag al schade. Wanneer AI de ontdekking van geneesmiddelen versnelt, nieuwe materialen helpt ontwerpen of wetenschappelijke verbanden vindt die mensen over het hoofd zien, heeft uitstel een concrete menselijke prijs.After all, a world without future AI solutions is not safe. Cancer, Alzheimer’s, heart disease, poverty, ageing and energy problems are already causing harm today. When AI speeds up drug discovery, helps design new materials or finds scientific connections that people overlook, delay has a concrete human price.
De verwachtingen zijn groot: vooruitgang in hersenonderzoek, schonere energie, productiviteitsgroei, ruimtevaart en misschien zelfs doorbraken als supergeleiding bij kamertemperatuur. Geen van deze resultaten is gegarandeerd. We weten niet of AI ze zal realiseren en al helemaal niet wanneer. Onzekerheid over de baten betekent alleen niet dat je ze op nul mag zetten. Beleid dat alleen mogelijke toekomstige schade meetelt en de kosten van gemiste vooruitgang negeert, is onvolledig. Het omgekeerde is eveneens waar: een mogelijke medische doorbraak is geen vrijbrief voor onbeheerst cyber- of biologisch risico.The expectations are high: progress in brain research, cleaner energy, productivity growth, space travel and perhaps even breakthroughs such as room-temperature superconductivity. None of these results is guaranteed. We do not know whether AI will deliver them and certainly not when. Uncertainty about the benefits, however, does not mean you may set them to zero. Policy that counts only possible future harm and ignores the cost of missed progress is incomplete. The reverse is equally true: a possible medical breakthrough is no licence for uncontrolled cyber or biological risk.
Reken en redeneer daarom preciezer, met zes vragen per mogelijkheid.So calculate and reason more precisely, with six questions per capability.
- Welke mogelijkheid levert aantoonbare waarde?Which capability delivers demonstrable value?
- Welk misbruik wordt daardoor mogelijk?What misuse does it make possible?
- Hoe waarschijnlijk zijn beide uitkomsten?How likely are both outcomes?
- Wie ontvangt de voordelen en wie draagt het gevaar?Who receives the benefits and who bears the danger?
- Is de schade omkeerbaar?Is the harm reversible?
- Kan een release worden beperkt wanneer de aannames niet blijken te kloppen?Can a release be restricted when the assumptions turn out to be wrong?
Dat is geen strijd tussen optimisten en pessimisten. Het is volwassen risicobestuur.That is not a battle between optimists and pessimists. It is mature risk governance.
De keuze die voor je ligtThe choice before you
De toekomst van AI wordt niet beslist met één druk op een rode of groene knop. Er is geen universele snelheid die voor ieder model, iedere toepassing en ieder land juist is. Wat je nodig hebt, is een selectieve en toetsbare benadering. Naarmate een systeem autonomer wordt, toegang krijgt tot gevoelige hulpmiddelen of gevaarlijke kennis praktisch toepasbaar maakt, worden de eisen zwaarder. Waar risico’s beperkt, zichtbaar en omkeerbaar zijn, kan meer ruimte voor experiment bestaan.The future of AI is not decided with one press of a red or green button. There is no universal speed that is right for every model, every application and every country. What you need is a selective and testable approach. As a system becomes more autonomous, gains access to sensitive tools or makes dangerous knowledge practically applicable, the requirements become heavier. Where risks are limited, visible and reversible, there can be more room for experiment.
Bekijk daarbij steeds vier lagen: het model, de technische omgeving, de mens en de organisatie en het institutionele kader. Een zwakte in één laag kan alle andere ondermijnen.Always look at four layers: the model, the technical environment, people and organisation and the institutional framework. A weakness in one layer can undermine all the others.
Wie bepaalt de norm, wie houdt toezicht en wie legt verantwoording af wanneer het misgaat?Who sets the standard, who oversees and who is held accountable when things go wrong?
Wie gebruikt het, met welk doel en onder welke controles?Who uses it, for what purpose and under which controls?
Tot welke gegevens, netwerken en hulpmiddelen krijgt het toegang?Which data, networks and tools does it gain access to?
Wat kan het en welke grenzen zijn erin aangebracht?What can it do and which limits are built into it?
Een zorgvuldig getraind model kan schade veroorzaken in een verkeerd geconfigureerde omgeving.A carefully trained model can cause harm in a misconfigured environment.
Een technisch goed beveiligd systeem kan worden misbruikt door een bevoegde gebruiker.A technically well-secured system can be misused by an authorised user.
Een verantwoordelijk bedrijf kan onder verkeerde marktprikkels toch te vroeg lanceren.A responsible company can still launch too early under the wrong market incentives.
Ambitieuze wetgeving kan falen wanneer zij technisch achterhaald of internationaal eenvoudig te omzeilen is.Ambitious legislation can fail when it is technically outdated or easy to circumvent internationally.
Daarom laat je veiligheid niet alleen aan technici over. Je laat haar evenmin uitsluitend aan politici, juristen of ondernemingsbestuurders over. Dit vraagstuk vraagt om gedeelde deskundigheid en verdeelde macht.That is why you do not leave safety to technicians alone. Nor do you leave it solely to politicians, lawyers or company boards. This problem calls for shared expertise and divided power.
De belangrijkste keuze gaat dus niet over remmen of versnellen. Zij gaat over de vraag of we bereid zijn een bestuursvorm te bouwen die tegelijk waakzaam en ambitieus is: streng waar de gevolgen onomkeerbaar kunnen zijn, open waar experiment verantwoord is, kritisch op commerciële belangen en eerlijk over de maatschappelijke prijs van uitstel. Wie alleen naar de technologie kijkt, mist de macht en de prikkels eromheen. Wie alleen naar belangen en macht kijkt, onderschat reële technische gevaren. En wie uitsluitend bang is voor wat AI kan vernietigen, vergeet wat zij misschien kan helpen genezen, ontdekken en opbouwen.So the most important choice is not about slowing down or speeding up. It is about whether we are prepared to build a form of governance that is vigilant and ambitious at the same time: strict where the consequences can be irreversible, open where experiment is responsible, critical of commercial interests and honest about the social price of delay. Whoever looks only at the technology misses the power and incentives around it. Whoever looks only at interests and power underestimates real technical dangers. And whoever is only afraid of what AI can destroy forgets what it may help to cure, discover and build.
Voor jouw organisatie is dat herkenbaar: geef je AI toegang tot netwerken, transacties of gegevens, dan bekijk je daarbij steeds diezelfde vier lagen. De toekomst vraagt om iets moeilijkers dan blind vertrouwen of verlammende angst: het vermogen om vooruit te gaan zonder je handen van het stuur te halen.Your organisation will recognise this: if you give AI access to networks, transactions or data, you look at those same four layers every time. The future asks for something harder than blind trust or paralysing fear: the ability to move forward without taking your hands off the wheel.
Dit artikel is op eigen titel geschreven door Wil Peters RA RE en is gebaseerd op eigen onderzoek en opgedane ervaringen met AI.This article was written by Wil Peters RA RE in a personal capacity and is based on his own research and experience with AI.